开源推荐
2025 开源推荐:uv —— 用 Rust 重写的 Python 包管理器,快到飞起
napcat-java-agent:内置 AI Agent 的 Java QQ Bot 框架
开源推荐|Dify —— 一站式开源 LLM 应用开发平台
Open WebUI:最强大的自托管 AI 聊天界面
DuckDB——嵌入式OLAP数据库,数据分析的瑞士军刀
Kondo:一键清理项目构建产物,回收磁盘空间神器
CrewAI:角色驱动的多 Agent 协作框架,让 AI 团队为你工作
OpenHands:让 AI 自主编码的开源编程代理
Void Editor:开源 AI 代码编辑器,Cursor 的隐私替代方案
本站点使用 MrDoc 构建
-
+
DuckDB——嵌入式OLAP数据库,数据分析的瑞士军刀
> 分类:开源推荐 | 发布时间:2026-05-17 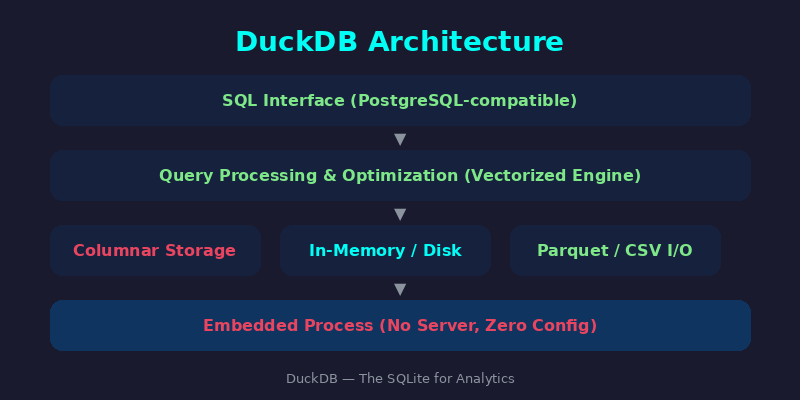 ## 一句话介绍 DuckDB 是一个**进程内(嵌入式)分析型数据库**,专为 OLAP 场景设计——无需安装服务器、零配置启动,一条 `pip install duckdb` 即可拥有媲美 ClickHouse 的查询性能。被社区称为“分析界的 SQLite”。 ## 核心亮点 - ⚡ **向量化执行引擎**:列式存储 + 向量化计算,OLAP 查询速度比 SQLite 快 10-100 倍 - 🔌 **零配置嵌入式**:无需启动数据库服务,直接嵌入 Python/R/Node.js 进程,像 SQLite 一样简单 - 📊 **原生 Parquet/CSV 支持**:直接查询 Parquet、CSV、JSON 文件,无需预先导入 - 🌐 **丰富的扩展生态**:httpfs 读 S3/GCS、postgres_scanner 读 PG、sqlite_scanner 读 SQLite - 🐍 **无缝对接 Pandas/Polars/Arrow**:一行代码互转,数据科学工作流零摩擦 - 🛡 **ACID 事务 + 崩溃恢复**:生产级可靠性,不是玩具 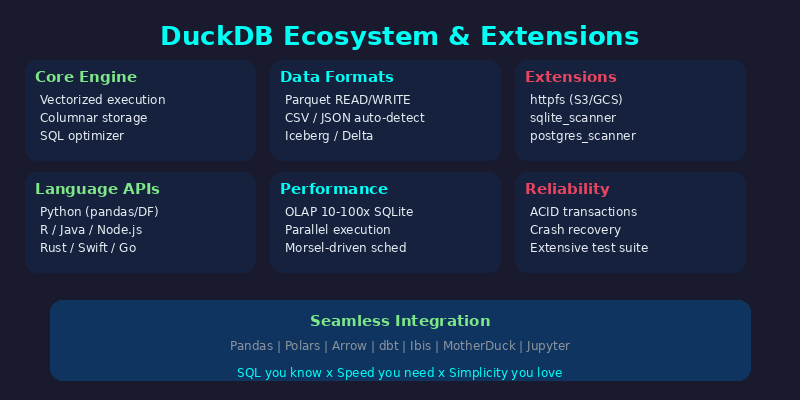 ## 快速上手 安装: ```bash pip install duckdb ``` 30 秒体验: ```python import duckdb # 直接查询 Parquet 文件,无需导入 result = duckdb.sql(""" SELECT region, SUM(sales) AS total FROM 'sales_data.parquet' WHERE year = 2025 GROUP BY region ORDER BY total DESC """).df() # 一键转 Pandas DataFrame print(result) # 也能直接查 CSV duckdb.sql("SELECT * FROM 'users.csv' LIMIT 5").show() # 内存中创建表并分析 con = duckdb.connect('analytics.db') # 持久化到文件 con.execute(""" CREATE TABLE IF NOT EXISTS events AS SELECT * FROM read_json_auto('events.json') """) con.execute(""" SELECT date_trunc('month', timestamp) AS month, count() AS events, count(DISTINCT user_id) AS active_users FROM events GROUP BY month ORDER BY month """).fetchall() ``` 远程数据一键查询(需安装 httpfs 扩展): ```python duckdb.sql(""" INSTALL httpfs; LOAD httpfs; SELECT * FROM read_parquet('s3://my-bucket/data/*.parquet') LIMIT 10 """) ``` ## 适用场景 | 场景 | 推荐指数 | 说明 | |------|---------|------| | 本地数据分析(替代 Pandas) | ⭐⭐⭐⭐⭐ | SQL 比 Pandas 链式调用更直观,性能更优 | | 数据管道 ETL 中间处理 | ⭐⭐⭐⭐⭐ | 嵌入式 + Parquet 原生支持,轻量高效 | | Jupyter/Notebook 探索性分析 | ⭐⭐⭐⭐⭐ | 与 Pandas/Polars 无缝互转 | | 替代小型 ClickHouse 集群 | ⭐⭐⭐⭐ | 单机场景无需运维,性能够用 | | 嵌入式应用的数据引擎 | ⭐⭐⭐⭐ | 类 SQLite 但支持复杂分析查询 | | 流式/实时数据处理 | ⭐⭐⭐ | 不擅长高并发写入,更偏批处理 | | 超大数据集(TB 级) | ⭐⭐ | 单机内存限制,考虑 ClickHouse/Spark | 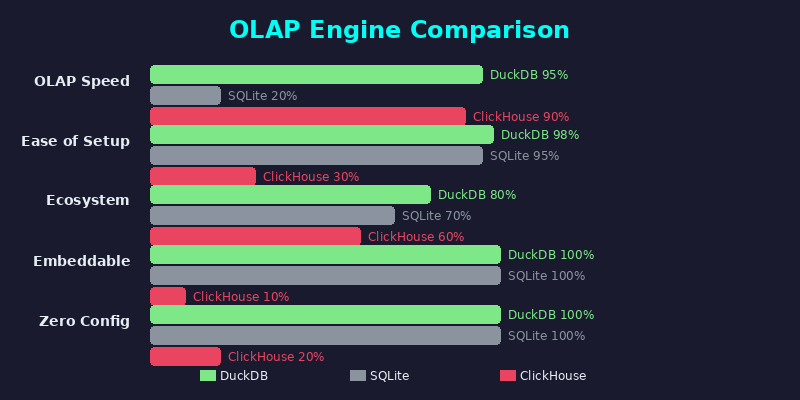 ## 与同类项目对比 | 特性 | DuckDB | SQLite | ClickHouse | Apache Spark | |------|--------|--------|------------|-------------| | 架构 | 嵌入式 | 嵌入式 | C/S 集群 | C/S 集群 | | 定位 | OLAP 分析 | OLTP 事务 | OLAP 大规模 | 大数据计算 | | 安装复杂度 | pip install | pip install | 需部署服务 | 需部署集群 | | OLAP 查询性能 | ★★★★★ | ★★ | ★★★★★ | ★★★★ | | 并发写入 | 弱 | 强 | 强 | 强 | | Parquet 原生 | ✅ | ❌ | ✅ | ✅ | | SQL 兼容性 | PostgreSQL | SQL 标准 | 部分 PG | Hive SQL | | 语言绑定 | Python/R/JS/Go… | Python/C/… | HTTP/JDBC | Python/Scala/Java | | 适用数据量 | MB~几十 GB | MB~几 GB | GB~PB | GB~PB | | 运维成本 | 零 | 零 | 中 | 高 | ## 实战建议 1. **从 Pandas 迁移**:把 `df.groupby().agg()` 替换为 `duckdb.sql("SELECT ... GROUP BY")`,代码更清晰、速度更快 2. **配合 dbt 使用**:dbT-duckdb 适配器让你在本地跑 dbt,无需数据仓库 3. **数据湖查询**:httpfs + Parquet = 零拷贝查询 S3 数据湖 4. **CI/CD 中的数据验证**:嵌入式特性非常适合在流水线中做数据质量检查 ## 相关链接 - 🔗 GitHub:[https://github.com/duckdb/duckdb](https://github.com/duckdb/duckdb)(28k+ ⭐) - 🌐 官网:[https://duckdb.org](https://duckdb.org) - 📖 文档:[https://duckdb.org/docs](https://duckdb.org/docs) - 🧩 扩展市场:[https://duckdb.org/docs/extensions/overview](https://duckdb.org/docs/extensions/overview) - 🐍 Python 包:[https://pypi.org/project/duckdb](https://pypi.org/project/duckdb) --- > 💡 **一句话总结**:如果你做数据分析还在手写 Pandas 复杂聚合,或者为了查个 Parquet 文件搭一套 ClickHouse——试试 DuckDB,它会改变你的工作方式。
admin
2026年5月17日 01:13
转发文档
收藏文档
上一篇
下一篇
手机扫码
复制链接
手机扫一扫转发分享
复制链接
Markdown文件
PDF文档(打印)
分享
链接
类型
密码
更新密码