GitHub热门
Ollama:一行命令跑起大模型,本地 LLM 推理的终极方案
GitHub热门解析|Marimo:下一代 Python 反应式笔记本
Zed:用 Rust 重写编辑器性能天花板
Hono:多运行时超快 Web 框架,TypeScript 的下一个选择
GitHub 热门项目解析:Zed Editor —— Rust 重塑代码编辑器的未来
GitHub 热门项目解析:Zed Editor —— Rust 重塑代码编辑器的未来
Hermes Agent:唯一内置学习循环的自进化 AI Agent
本站点使用 MrDoc 构建
-
+
Ollama:一行命令跑起大模型,本地 LLM 推理的终极方案
> 分类:GitHub热门 | 发布时间:2026-05-16 | 阅读时间:12 分钟 --- ## 项目概览 | 属性 | 详情 | |------|------| | **项目名** | ollama/ollama | | **GitHub Stars** | 175k+ | | **主要语言** | Go (后端) + C/C++ (推理引擎) | | **License** | MIT | | **一句话** | 本地运行 LLM,像 Docker 管容器一样管理大模型 | Ollama 是一个轻量级的本地大语言模型运行框架,让你能在自己的机器上一行命令启动 LLM 推理服务。它把 llama.cpp 的复杂性封装成 `ollama run llama3` 这样的简洁体验,同时提供了兼容 OpenAI 的 REST API,可以无缝对接各种下游应用。 ## 为什么火? **1. 极致简单的用户体验** 不需要配 Python 环境、不需要装 CUDA、不需要理解 GGUF 量化参数。下载二进制 → `ollama run llama3` → 开始聊天。这种"开箱即用"的体验直接把本地 LLM 的门槛降到了零。 **2. Docker 式的模型管理** Ollama 借鉴了 Docker 的设计哲学: - `ollama pull llama3` — 拉取模型(类似 docker pull) - `ollama run llama3` — 运行模型(类似 docker run) - `ollama list` — 查看已下载模型(类似 docker images) - `ollama rm llama3` — 删除模型(类似 docker rmi) 这种隐喻让任何用过 Docker 的开发者都能秒上手。 **3. OpenAI 兼容 API** Ollama 启动后默认监听 `http://localhost:11434`,提供 `/api/chat`、`/api/generate` 等接口,格式与 OpenAI API 高度兼容。这意味着 LangChain、LlamaIndex 等框架可以零配置接入。 **4. 活跃的模型生态** 从 Llama、Mistral、Gemma 到 Qwen、DeepSeek,主流开源模型几乎第一时间就能在 Ollama 上用。社区还贡献了大量 Modelfile(类似 Dockerfile),支持自定义 Prompt、参数和系统提示词。 --- ## 核心架构解析 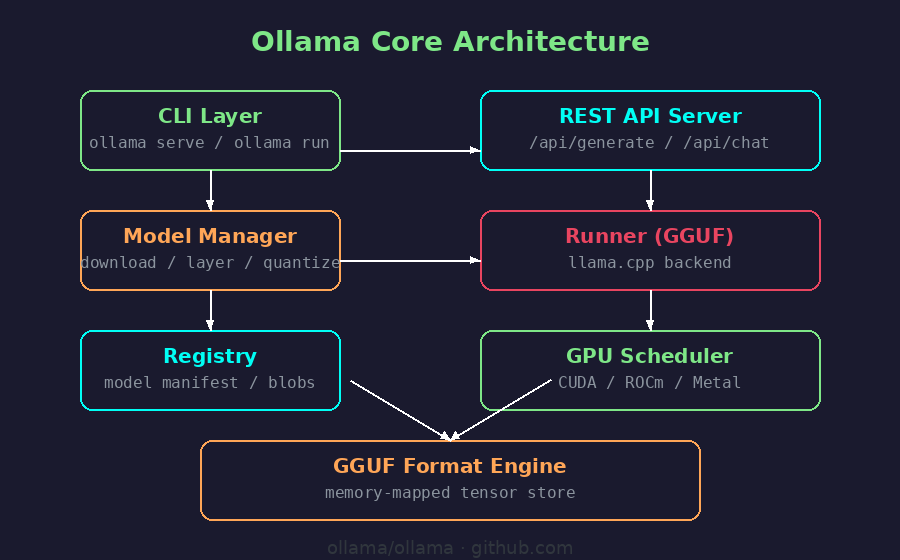 ### 整体分层 Ollama 的架构分为四层,自上而下: **① CLI 层** — 用户交互入口 - `ollama serve`:启动后台服务(API Server + Runner 管理器) - `ollama run`:启动交互式聊天 - `ollama pull/push`:模型仓库操作 **② API Server 层** — Go 实现的 HTTP 服务器 - 路由注册在 `server/routes.go`,核心端点: - `POST /api/generate` — 文本生成 - `POST /api/chat` — 多轮对话 - `POST /api/embeddings` — 文本向量化 - `GET /api/tags` — 列出本地模型 - 负责请求解析、流式响应(SSE)、并发控制 **③ Model Manager 层** — 模型生命周期管理 - 从 Registry 下载模型 manifest 和 blob - 解析 GGUF 文件格式,提取 tensor 元信息 - 管理模型的 layer 缓存和去重(类似 Docker 的 layer sharing) **④ Runner 层** — 推理执行引擎 - 对 llama.cpp 的 C/C++ 代码进行 Go 绑定(CGO) - 管理 GPU 内存分配(CUDA / ROCm / Metal) - 支持多 GPU 并行、KV Cache 管理、批处理调度 ### 关键设计决策 **为什么用 Go + C 而不是纯 Python?** - Go 编译为静态二进制,无运行时依赖 → 用户零配置 - Go 的 goroutine 天然适合高并发 API 服务 - llama.cpp 核心用 C/C++ → 性能关键路径不走 GC **GGUF 格式为什么重要?** - 单文件打包所有 tensor + metadata → 下载和分发极简 - 支持多种量化格式(Q4_0, Q5_K_M, Q8_0 等)→ 灵活权衡精度/速度 - Memory-mapped 加载 → 大模型不需要全部读入内存 --- ## 关键代码片段 ### 1. Modelfile — 模型定义(类似 Dockerfile) ```dockerfile FROM llama3 # 设置系统提示词 SYSTEM 你是一个专业的Go语言工程师,回答要简洁、准确。 # 设置参数 PARAMETER temperature 0.7 PARAMETER top_p 0.9 PARAMETER num_ctx 4096 # 自定义模板 TEMPLATE """{- if .System }<|start_header_id|>system<|end_header_id|> { .System }<|eot_id|> {- end } <|start_header_id|>user<|end_header_id|> { .Prompt }<|eot_id|> <|start_header_id|>assistant<|end_header_id|> { .Response }<|eot_id|>""" ``` ### 2. Go 中的流式响应实现 ```go // server/routes.go 核心逻辑(简化) func (s *Server) GenerateHandler(c *gin.Context) { req := parseRequest(c) // 获取或创建 Runner 实例 runner, err := s.runnerMgr.GetRunner(req.Model) if err != nil { c.JSON(500, gin.H{"error": err.Error()}) return } // 流式输出 c.Header("Content-Type", "text/event-stream") ch := runner.Generate(req.Prompt, req.Params) for token := range ch { data, _ := json.Marshal(gin.H{ "response": token, "done": false, }) fmt.Fprintf(c.Writer, "data: %s\n\n", data) c.Writer.Flush() } // 发送完成信号 fmt.Fprintf(c.Writer, "data: {"done": true}\n\n") } ``` ### 3. GPU 内存调度 ```go // gpu/gpu.go — 选择最佳 GPU 加载模型 func GetGPUInfo() []GpuInfo { // 检测 CUDA / ROCm / Metal 可用性 // 返回显存大小、计算能力等信息 } func (lm *LayerManager) LoadLayers(modelPath string) error { info := GetGPUInfo() // 按 GPU 显存大小分配 tensor layers // 小显存 GPU:部分 offload 到 CPU // 多 GPU:按 layer 分片到不同设备 } ``` --- ## 设计模式解析 ### 1. 客户端-服务器架构(Local-First) Ollama 采用本地 C/S 架构:`ollama serve` 启动常驻服务,CLI 和外部程序都通过 HTTP API 通信。好处: - **多客户端复用**:终端、Web UI、IDE 插件可以同时连同一个服务 - **模型热加载**:第一次加载后常驻内存,后续请求秒响应 - **沙箱隔离**:推理进程独立,崩溃不影响调用方 ### 2. 仓库模式(Registry Pattern) 模型分发借鉴 OCI(Open Container Initiative)规范: - 每个 Model 有一个 manifest(描述各 layer) - 每个 layer 是一个 blob(权重文件的分片) - 支持 digest 校验和去重 这意味着 Ollama 的模型仓库可以直接对接 OCI 兼容的存储后端。 ### 3. 进程池模式(Runner Pool) GPU 资源有限,Ollama 用 Runner Pool 管理推理进程: - 同一模型只保留一个 Runner 实例(单例) - 不同模型的 Runner 按需加载/卸载 - 空闲超时自动释放 GPU 显存 ### 4. 零配置哲学(Convention over Configuration) - 默认端口 11434,不需要改 - 默认模型存储 `~/.ollama/models` - 默认自动检测 GPU,不需要手动指定 - 只有高级用户才需要翻 Modelfile --- ## Star 增长趋势 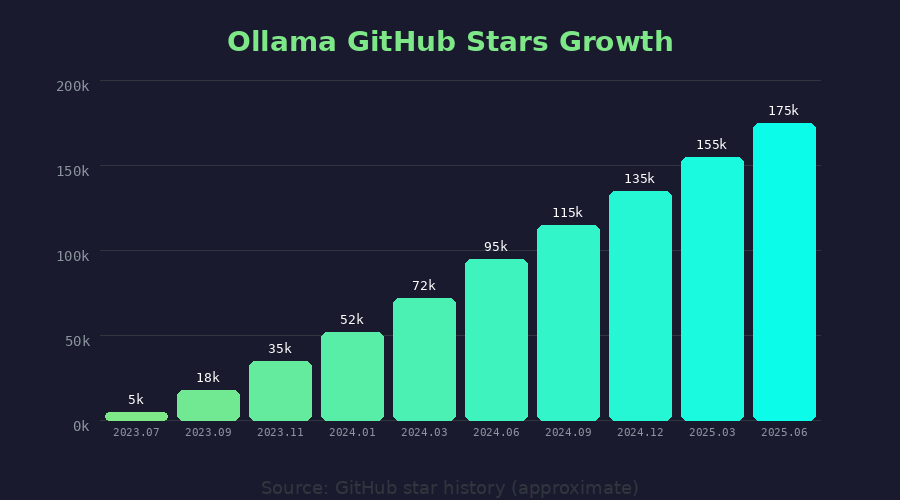 从 2023 年 7 月发布至今,Ollama 的 Star 数从 0 增长到 175k+,增长曲线呈现典型的"爆款开源项目"特征:前期社区口碑传播带来指数增长,中期靠持续迭代和模型生态维持热度,后期凭借 OpenAI 兼容 API 进入生产级应用场景。 关键增长节点: - **2023.07** — 首次发布,Llama 2 开源引爆本地推理需求 - **2023.11** — 支持 AMD GPU(ROCm),用户群翻倍 - **2024.03** — 引入 Modelfile,社区自定义模型爆发 - **2024.09** — OpenAI 兼容 API,企业级应用接入 - **2025.03** — 多模态支持(LLaVA),覆盖视觉场景 --- ## 如何参与 ### 快速上手 ```bash # macOS / Linux curl -fsSL https://ollama.com/install.sh | sh # 运行第一个模型 ollama run llama3 # 查看已下载模型 ollama list # 创建自定义模型 ollama create mybot -f Modelfile ``` ### 贡献方式 | 类型 | 方式 | |------|------| | **Bug 报告** | GitHub Issues,附上 `ollama --version` 和日志 | | **新模型适配** | 提交 Modelfile 到 ollama.com/model-library | | **代码贡献** | Go 后端 PR / llama.cpp 绑定改进 | | **文档** | 修复 README 和 API 文档中的错误 | ### 值得关注的方向 - **多模态推理**:图像、音频输入的处理管线 - **分布式推理**:多机多卡协同(Tensor Parallel) - **Agent 框架集成**:与 LangChain/CrewAI 深度整合的工具调用能力 - **企业级特性**:RBAC、审计日志、模型版本管理 --- > 本文基于 Ollama GitHub 仓库(github.com/ollama/ollama)源码和官方文档撰写,架构图和增长数据为作者分析整理,仅供参考。
admin
2026年5月16日 18:20
转发文档
收藏文档
上一篇
下一篇
手机扫码
复制链接
手机扫一扫转发分享
复制链接
Markdown文件
PDF文档(打印)
分享
链接
类型
密码
更新密码